分割 42.6 FPS:金标对不上,先查输入
FastSAM-s 42.6 FPS(官方管线 1.9 倍)。金标 IoU 0.808 对不上,九轮破案:rect letterbox 张量错位是天花板,tensor 参考法定案 0.9959。
本页目录
FastSAM-s 上板:42.59 FPS,官方管线的 1.9 倍。但这篇的主角是压测之前那场破案——我方 mask 与官方对比,IoU 只有 0.808。按惯例低于 0.9 就该停下来查,这个 0.808 用了九轮才拆干净。
破案九轮,压成八句
- 假设一"官方先 sigmoid 再阈值"——读源码证伪:logits 在线性域直接 >0。
- 假设二"160 网格先阈值再上采样"——实测证伪:小实例面积只剩 1/2.5。插值和阈值的顺序不可换。
- 对齐官方语义后仍然 0.808——还有隐藏因素。
- 官方图像路径用 rect letterbox:810×1080 缩成 640×480 无 pad,我方是 640×640 方形——这是两个不同的输入张量,直比的天花板 ~0.85。
- 官方还有框侧语义:贴边框往外吸 20px、box_iou>0.9 的框直接扩成全图——双方用的根本不是同一组框。
- 解法 = 消灭变量:tensor 输入直接喂官方模型,强制同一张量,四级对比一次只测一件事。
- D2a1 纯解码数学 0.9959(p50 逐位一致 1.0000)、D2b fp16 噪声 0.9971——两个硬断言通过。
- 谜底:不是"我方错了",是双方在比两个不同的东西。
一句话带走:金标对不上,先查输入张量是不是同一个。
overlay 三级跳:31→9.53ms
摄像头档预算 33.3ms,overlay 初版 31ms 直接爆。三级优化:
| 版本 | 方案 | 720p 实测 |
|---|---|---|
| v1 | numpy 逐像素混合 | 31.0 ms |
| v2 | 全 cv2 SIMD:GPU amax 合成 label → LUT 上色 | 11.9 ms |
| v3 | + GPU 侧裁掉 letterbox pad + 缓冲复用 | 9.53 ms |
中间差点被骗:amax 在 4D 上做 43.8ms,squeeze(1) 后 3D 只要 3.1ms——14 倍的差距就在一次 squeeze,首测差点得出"amax 不可行"的错误结论。优化前先 profile 单项,别信直觉。
碎,是本性不是 bug
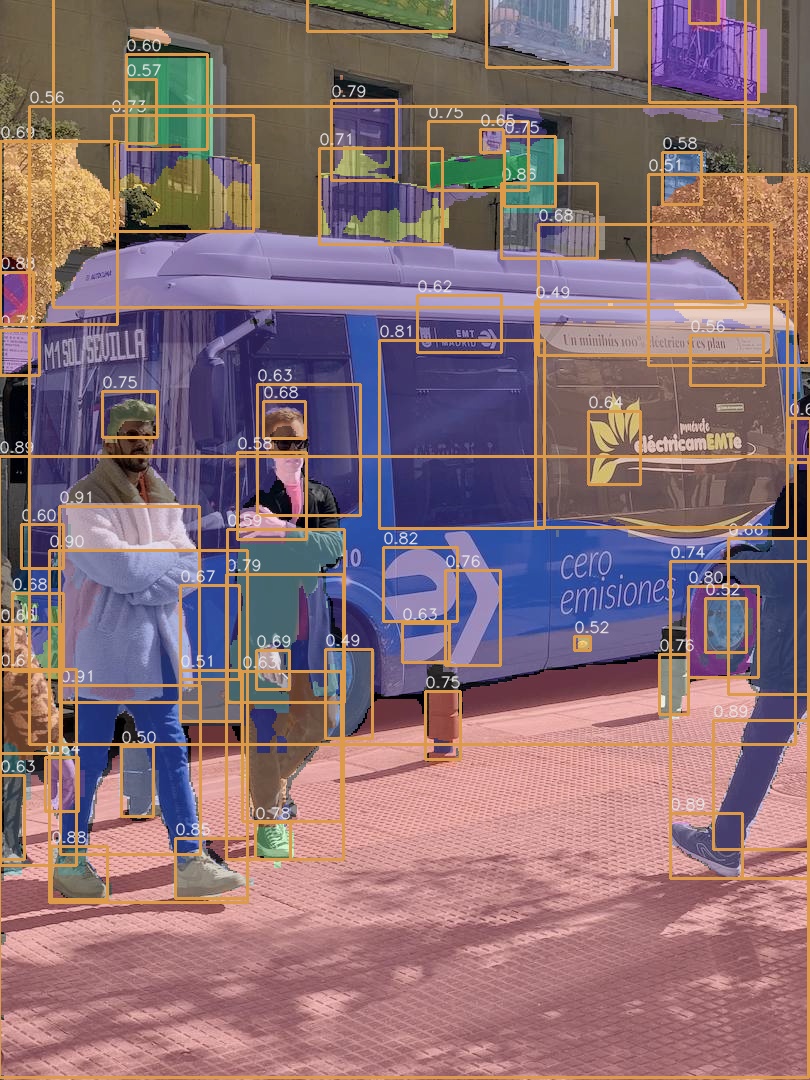
bus.jpg 满载 64 实例,人被拆成外套/裤子/头几个段——第一次看到会以为部署坏了。金标证明我方输出与官方逐位一致(p50 IoU 1.0000):FastSAM 的 everything 模式输出的是视觉段,不是语义物体。语义级抠像要上提示模式或原版 SAM;顺带实测 box prompt 也只返回主视觉段——“框里抠出完整的人"这张支票开不得。
成绩单
- 图片回放(64 实例满载)42.59 FPS,pre 2.71 / infer 9.09 / post+mask 11.44ms——engine 从来不是瓶颈(median 8.49ms,上限 ~118),FPS 是后处理和 overlay 优化挣出来的
- 摄像头 720p30 满帧零丢,e2e P50 31.11ms
- 功耗 17.2W(图片满载)/ 12.8W(摄像头被 30fps 节流),结温 50.2℃
- 42.59 低于 spike 预期 60-80 的原因也定案了:spike 用"先阈值"快口径,正式版换成官方 bilinear 后阈值——正确性换速度,明码标价
环境口径:Jetson Orin Nano Super 8GB / JetPack 6 / TensorRT 10.7 / CUDA 12.6;bus.jpg 为 ultralytics 官方示例图;锁频 1020MHz 满频占比 100%,900 帧,2026-11 实测。