满帧只是及格线:延迟与能耗才是差距
三档频率策略净帧率全是 30.04,延迟差 2.5 倍、每帧能耗差 2.37 倍。附 6.58ms 延迟瀑布和 DVFS 能耗暴论。
本页目录
上一章 165 FPS 的流水线,换上摄像头当恒定 30fps 测试信号源跑实时,满帧 30.04 只是及格线——帧率这根指针到顶了,系统的差距全藏在延迟和能耗里。
三档对照:帧率一样,差距在别处
| 档 | 净帧率 | infer | e2e P50 | e2e P95 | 负载功耗 | 每帧能耗 |
|---|---|---|---|---|---|---|
| ① 锁频·基准 | 30.04 | 3.12ms | 6.58ms | 8.18ms | 9433mW | 61.8 mJ |
| ② 锁频·实时(丢旧保新) | 30.04 | 3.11ms | 6.72ms | 6.96ms | 9448mW | 62.4 mJ |
| ③ DVFS 自治 | 30.04 | 8.75ms | 16.75ms | 16.97ms | 8875mW | 146.3 mJ |
三件事:
- ①②看长尾。实时模式丢旧保新,消费端永远处理最新帧,P95 从 8.18 掐到 6.96ms,P50 几乎不动。延迟敏感的场景默认实时模式。
- ③是暴论。governor 把"每帧干 6.5ms 活歇 26ms"判断成不值得升频,停在 306MHz:infer 慢 ×2.8、e2e 慢 ×2.5,功率只省 6%(8875 vs 9433mW),每帧能耗反增 2.37 倍。低占空比恒定负载下放开 governor 是双输。(间歇触发的场景别直抄,按自己占空比重测。)
- 摄像头源对推理零惩罚:infer 3.12ms 与文件源逐位一致,实时化的税全在预处理 2.46ms 和结果回传 0.98ms。
延迟瀑布:你测到的只有右半段
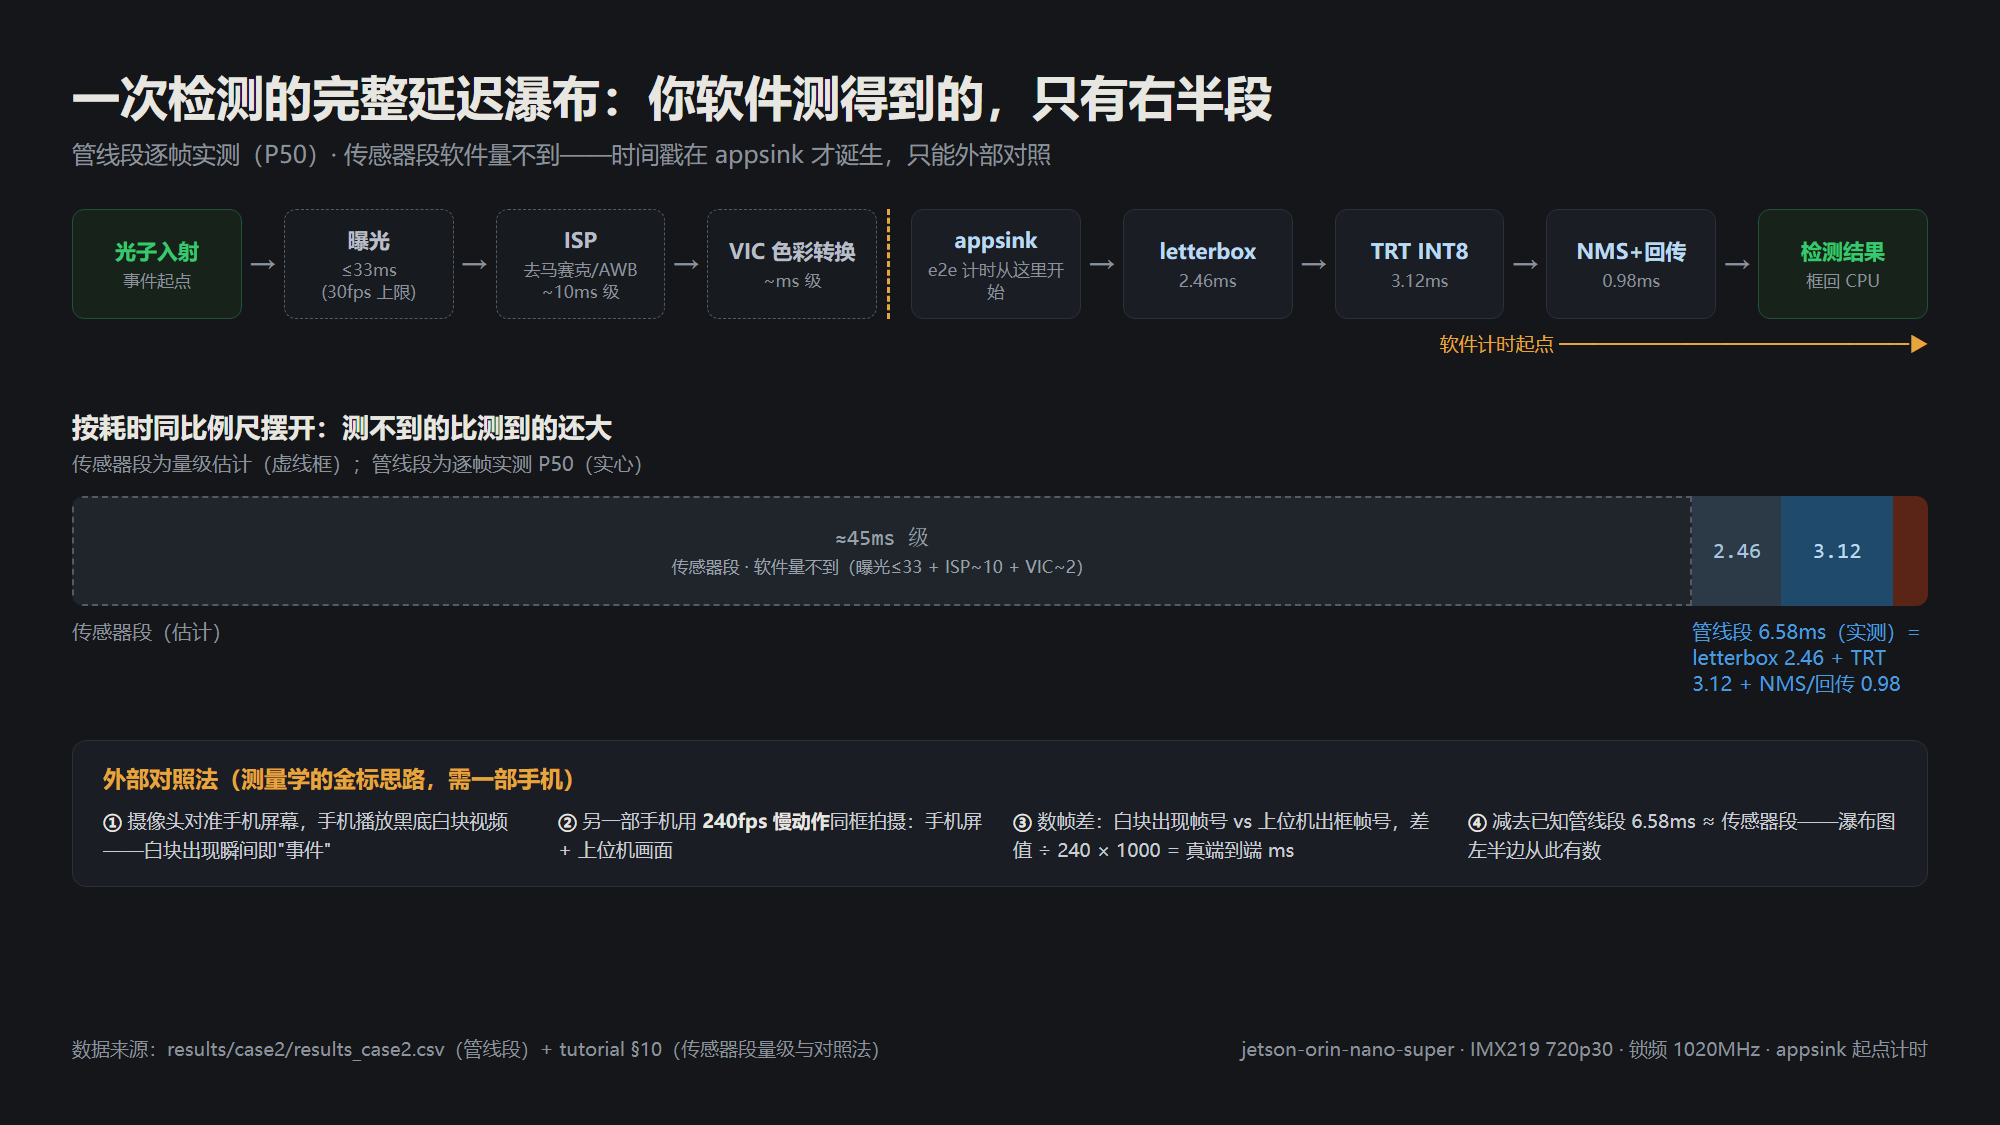
光子 → [曝光 ≤33ms] → [ISP ~10ms] → [VIC ~ms级]
     → appsink(e2e 计时从这里开始)
     → letterbox 2.46 → TRT 3.12 → NMS+回传 0.98 → 结果
不太舒服的事实:逐帧实测的 6.58ms,只占总延迟约八分之一。前面那段软件量不到——时间戳是 appsink 给的,帧在传感器和 ISP 里流转时对软件不可见。想要实测数得上外部对照法:手机屏放黑底白块当事件,另一部手机 240fps 慢动作同框拍屏幕和上位机,数帧差÷240。
对部署有用的推论:用户感知的"事件→出框"延迟 ≈ 45ms 级传感器段 + 6.58ms 管线段 + 显示器一帧(16~33ms)——瓶颈大概率是传感器和显示器,不是你的推理管线。优化别一上来就盯引擎。
e2e 会漂移,infer 不会
同日傍晚暗光重跑一遍:净帧率和 infer 逐位复现,e2e P50 却从 6.58 漂到 8.17。根因量化过:有检测的帧比空帧慢约 1.5ms(NMS 结果回传耗时随框数涨),暗光下误检变多,检测帧占比从 14% 涨到 96%,P50 被整体拉高。
教训:跨场次比较 e2e 必须同光照,或分列 e2e(有检)/e2e(空检);infer 与画面无关,是更稳的复现锚点。
两个坑
- 开机首会话 AE 全黑:首次会话偶发 AE 不收敛,抓出来全黑。先重跑一次(二次自愈是常态),仍黑就显式固定曝光 30ms 再验亮度。
- fps_effective 会冤枉自己:DVFS 档汇总里 fps_effective 25.21,看着掉了帧——逐帧日志 900 帧一帧不少,净帧率 30.04。差的 4.8fps 是启动/清理开销摊进了分母。恒定源下认净帧率(逐帧首尾差),不认 fps_effective。
环境口径:Jetson Orin Nano Super 8GB / JetPack 6 / TensorRT 10.7 / CUDA 12.6;锁频 1020MHz 满频占比 100%(DVFS 档按设计 0%);每档 900 帧、预热帧剔除、丢帧 0、告警 0;2026-11 实测。